دسترسی بلادرنگ به دانش سازمانی با پایگاه داده برداری و جستجوی معنایی هیبریدی؛ پاسخدهی ۱۰۰٪ مستند، بدون توهم و در زیرساخت کاملاً محلی یا ابری ایزوله.
دریافت مشاوره معماری RAG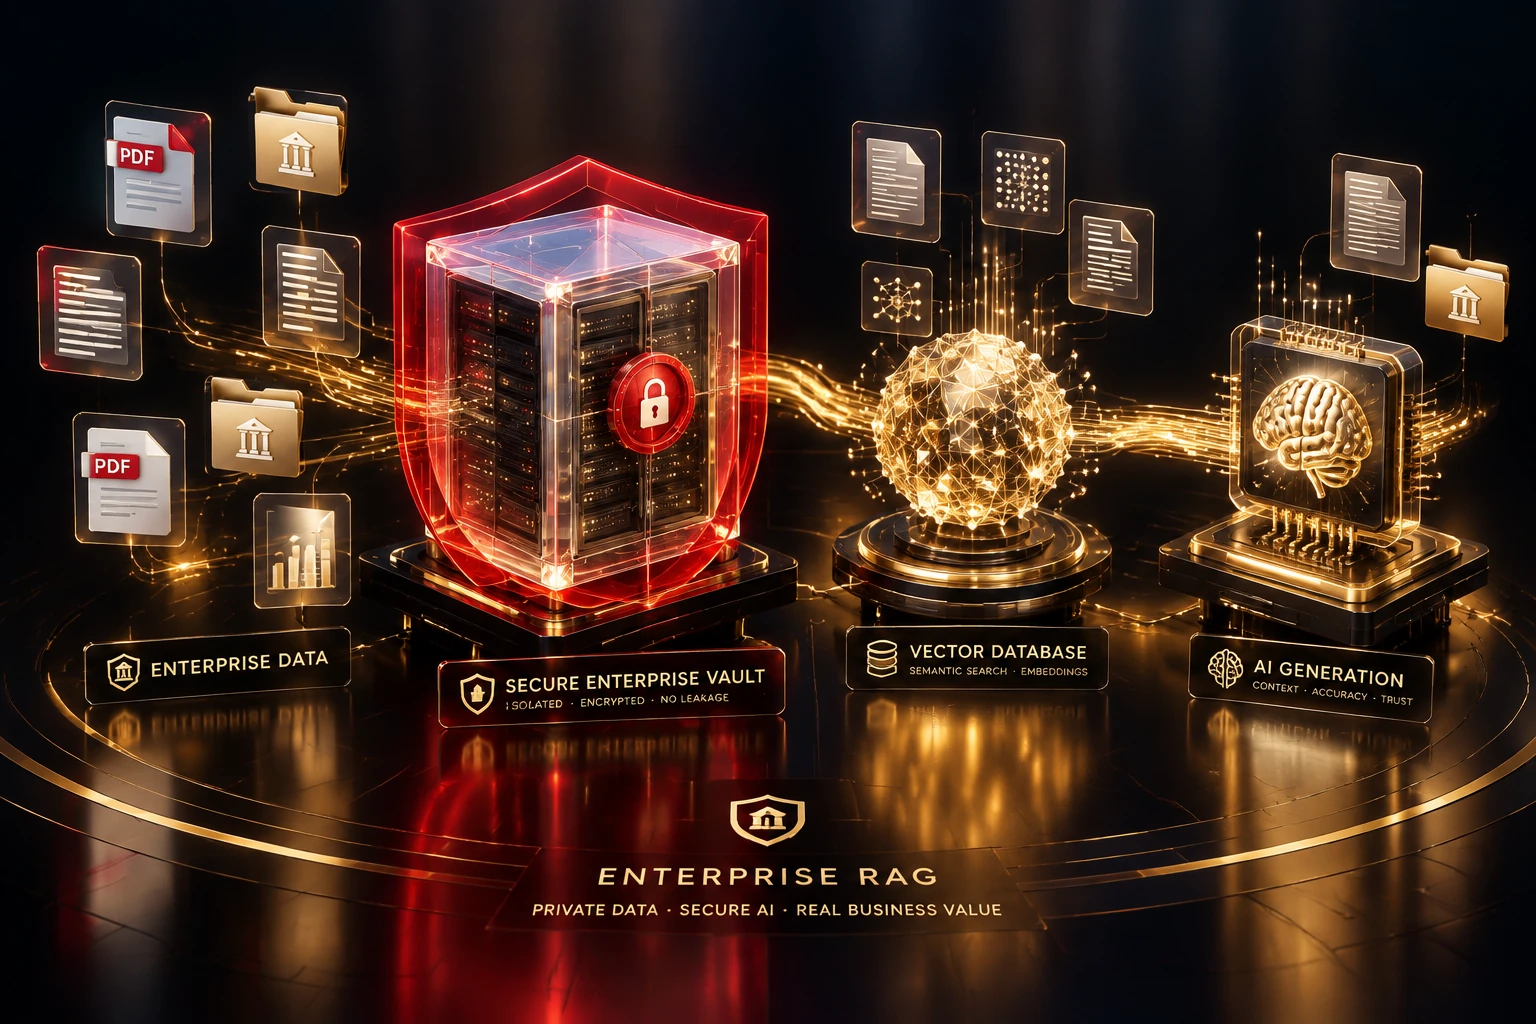
هزاران داکیومنت فنی، گزارش مالی و قرارداد در سازمان قفل شدهاند. ارسال آنها به هوشهای تجاری عمومی ریسک نشت داده دارد و LLMهای خام نیز اطلاعات دقیق سازمانی را نمیدانند.
با پیادهسازی سیستم RAG پیشرفته و پایگاه داده برداری ایزوله، هوش مصنوعی بدون نیاز به آموزش مجدد و با استناد مستقیم به اسناد شما، پاسخی سریع، دقیق و با دسترسی تفکیکشده ارائه میدهد.
زیرساختهای مهندسیشده فلات برای مقیاسپذیری
تقطیع هوشمند اسناد PDF، Word و دیتابیسها با Chunking پیشرفته و ایندکس در وکتور دیتابیسهای پرسرعت.
ترکیب جستجوی متنی کلمات کلیدی (BM25) با جستجوی معنایی و Re-ranking برای رسیدن به بالاترین دقت استخراج.
پاسخدهی مدل فقط بر پایه اسناد استخراجشده با درج منبع و لینک صفحه برای راستیآزمایی آنی مدیران.
اعمال مجوزهای دسترسی سازمانی (RBAC) در سطح هر سند و استقرار روی سرورهای داخلی بدون خروج داده.
فرآیند از تحلیل مسئله تا استقرار و بهرهبرداری کامل
دستهبندی داکیومنتها، حذف نویزها، متادیتاگذاری ساختاریافته و آمادهسازی جهت تزریق به موتور امبدینگ.
پیادهسازی منطق Hybrid Retrieval و Re-ranker همراه با بهینهسازی پرامپتهای استناددهی برای حذف کامل خطای توهم.
پیادهسازی منطق Hybrid Retrieval و Re-ranker همراه با بهینهسازی پرامپتهای استناددهی برای حذف کامل خطای توهم.
یکپارچهسازی با سامانه احراز هویت شرکت، اعمال فیلتر مجوز در ریتریوال و استقرار در زیرساخت سازمان.
نتایج حاصل از استقرار سیستمها در کسبوکارهای همکار
تیم مهندسی فلات بر اساس معماری دقیق دادهها و سناریوهای اختصاصی بیزینس شما، مسیر پیادهسازی را طراحی و پشتیبانی میکند.
دریافت برنامه عملیاتی و مشاوره فنیمدلهای زبانی بزرگ (LLM) امروزی بر پایه معماری ترنسفورمر (Transformer) ساخته شدهاند و دانش خود را در قالب حافظه پارامتریک (Parametric Memory) درون وزنهای شبکه عصبی ذخیره میکنند. این مدلها در درک زبان عمومی بینظیرند، اما دو عارضե بنیادین در محیطهای سازمانی دارند:
برای حل این چالش، راهکار علمی و مهندسی استاندارد در سطح جهان، استفاده از سیستمهای بازیابی-تقویتشده یا همان RAG (Retrieval-Augmented Generation) است که حافظه غیرپارامتریک (پایگاه دانش خارجی) را به مدل پیوند میزند.
پیادهسازی حرفهای RAG فراتر از اتصال یک API ساده است؛ این کار نیازمند طراحی دقیق یک خط لوله پردازشی (Data Pipeline) چندمرحلهای است:
یکی از خطاهای رایج در پیادهسازیهای ضعیف RAG، اتکا صرف به جستجوی وکتوری خالص است که گاهی به از دست رفتن کلمات کلیدی خاص (مثل کدهای محصول یا نامهای خاص) منجر میشود. در معماری استاندارد آژانس فلات، ما از جستجوی هیبریدی (Hybrid Search) استفاده میکنیم که ترکیب قدرتمندی از جستجوی کلمات کلیدی سنتی (Sparse Retrieval مانند BM25) و جستجوی معنایی (Dense Retrieval) است.
سپس با استفاده از مدلهای Cross-Encoder (Re-ranker)، اسناد بازیابیشده بر اساس میزان دقیق ربط به سوال کاربر مجدداً امتیازدهی و مرتب میشوند تا فقط ۱۰ سند عالی و کاملاً مرتبط به مدل زبانی تزریق شود. اینجاست که پیادهسازی RAG روی اطلاعات شرکت به نقطهی اتکای امن و دقیق دانش سازمانی تبدیل میشود.
در سازمانها، امنیت داده خط قرمز است. چالش اصلی در استفاده از هوش مصنوعی، دغدغۀ نشت اطلاعات تجاری به مدلهای عمومی است. معماری ما در فلات بر پایهی ایزولاسیون کامل دادهها بنا شده است:
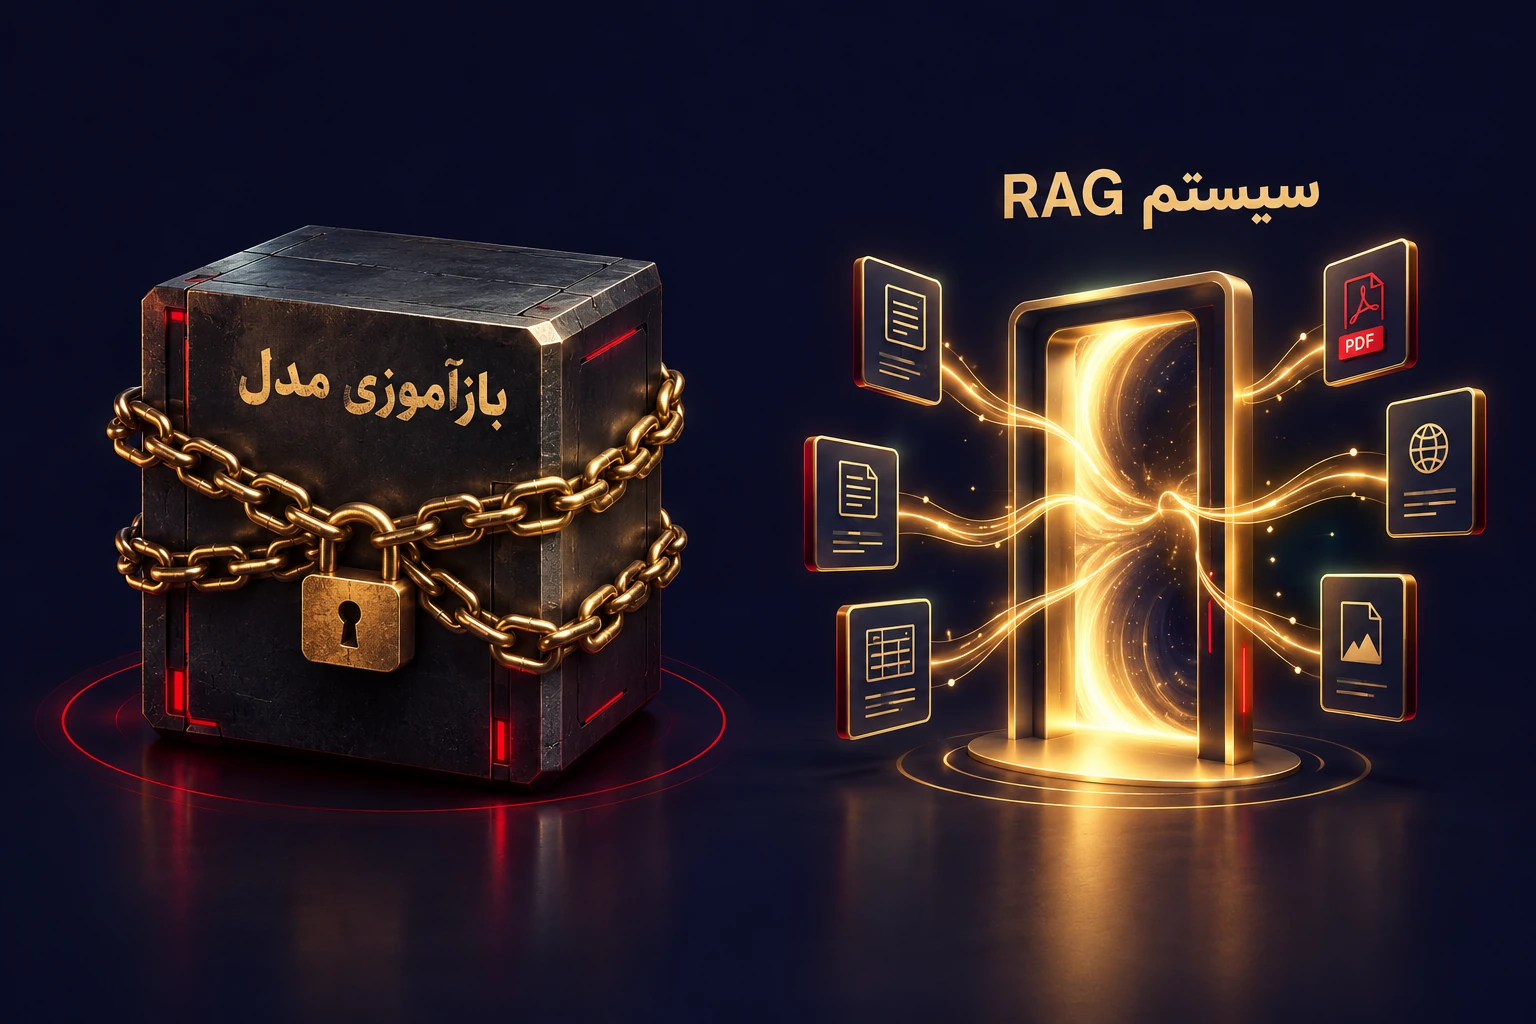
| شاخص مقایسه | Fine-Tuning (بازآموزی مدل) | RAG (بازیابی و تولید) |
|---|---|---|
| هزینه محاسباتی و مالی | بسیار بالا (نیازمند GPUهای سنگین) | بهینهسازی شده و اقتصادی |
| سرعت بهروزرسانی دانش | نیازمند بازآموزی کامل مدل (زمانبر) | آنی (با ویرایش یا حذف سند در دیتابیس) |
| قابلیت استناد و ممیزی (Auditability) | ندارد (دانش در وزنها گم میشود) | دارد (سیستم به سند دقیق ارجاع میدهد) |
| نرخ توهم (Hallucination) | بالاتر در مواجهه با دادههای جدید | بسیار پایین (محدود به اسناد بازیابیشده) |
پیادهسازی سیستم RAG سازمانی، پروژهای از جنس مهندسی داده و هوش مصنوعی است که نیازمند درک عمیق از ساختار دادههای شرکت، بهینهسازی الگوریتمهای بازیابی و معماری زیرساخت امن است. در آژانس فلات، ما فراتر از یک یکپارچهسازی سطحی عمل کرده و با اتصال نرم افزار سازمانی به هوش مصنوعی بر بستر یک خط لوله اختصاصی و ایزوله، به سازمان شما کمک میکنیم تا ضمن حفظ حریم خصوصی و امنیت کامل دادهها، از قدرت تحلیل پیشرفتهی مدلهای زبانی در تصمیمگیریهای کلان و عملیاتی بهرهمند شوید.
پاسخ به سوالات فنی و اداری پیش از شروع همکاری
فرم زیر را تکمیل کنید تا کارشناسان فنی فلات با شما تماس بگیرند